Как работают LLM-ки
2026-11-10 14:38 vak
Клод учит меня компилировать большие языковые модели. Покажу в картинках на примере SmolLM2-135M, небольшой модели из семейства llama.
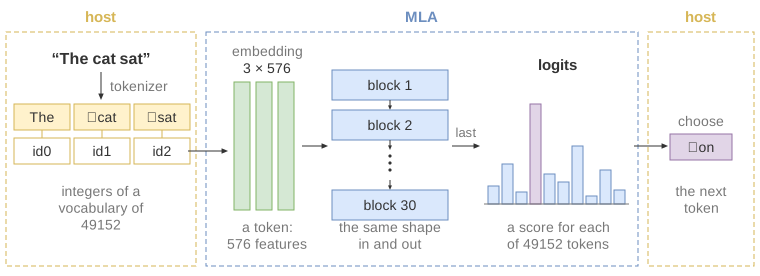
Что вычисляет LLM-ка? Принимает входную последовательность токенов и определяет следующий токен. Если вы не в курсе: токен это примерно одно слово.
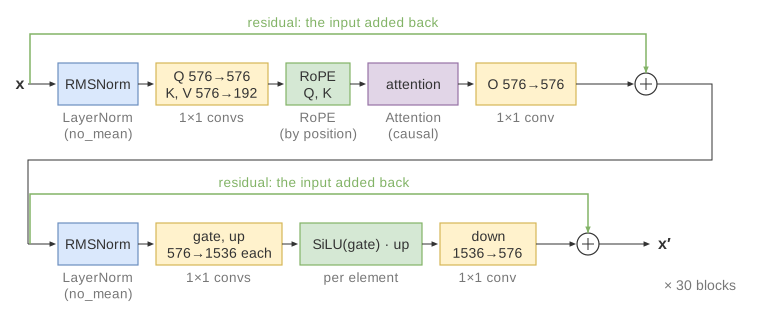
Внутреннее устройство одного (из тридцати) блока основного цикла обработки.
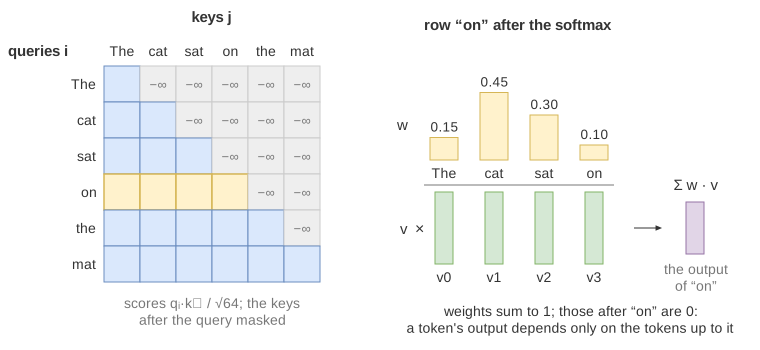
Как работает внимание. Откуда берётся "причинность": каждый токен видит только предыдущие, но не последующие.
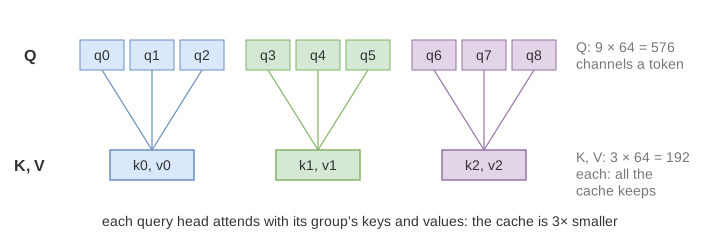
Важная оптимизация: группируем запросы по три штуки, чтобы уменьшить размеры кэша внимания.
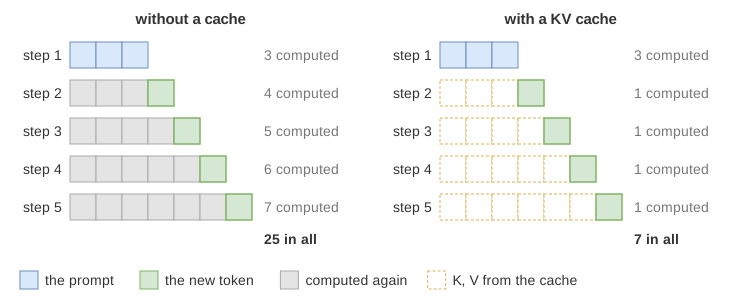
Как помогает кэш: не нужно перевычислять блоки, которые не меняются от шага к шагу.
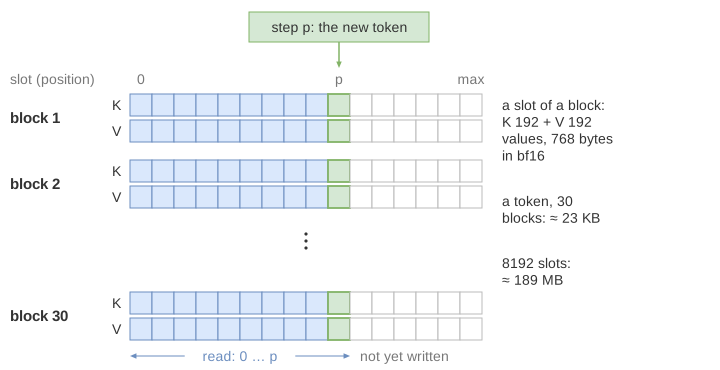
Устройство KV-кэша.
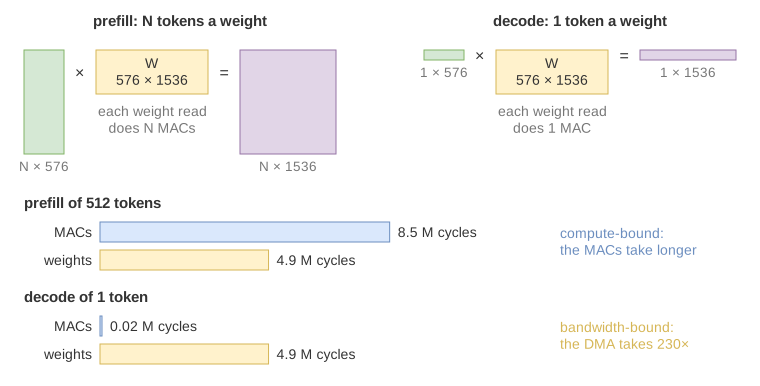
Две фазы выполнения LLM-ки: предварительное заполнение (однократно) и декодирование (в цикле).
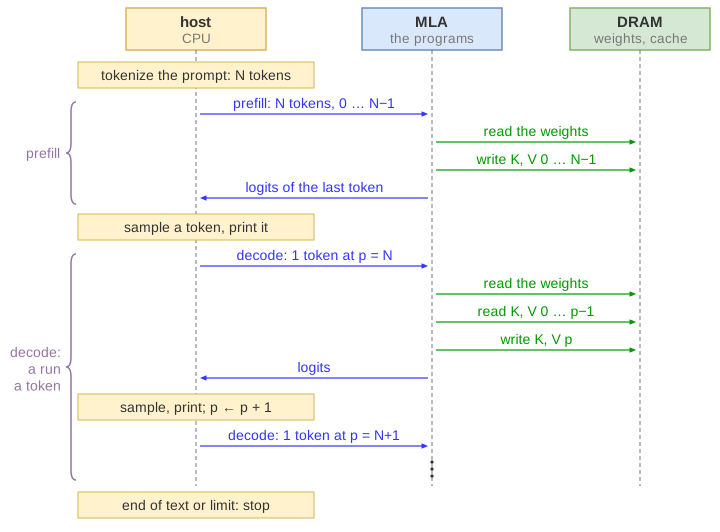
Как устроено LLM-приложение.
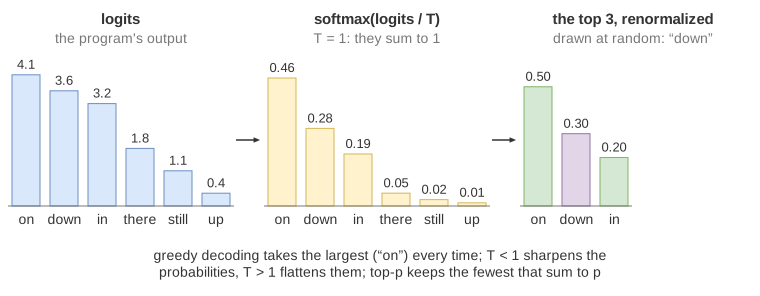
Как из вычисленных лоджитов образуется результирующий токен.
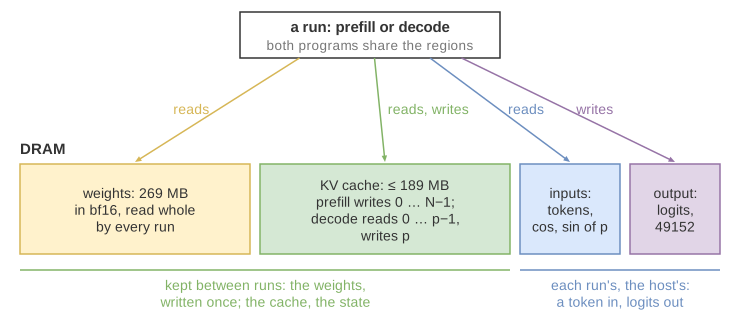
Куча мала в оперативной памяти.
Что вычисляет LLM-ка? Принимает входную последовательность токенов и определяет следующий токен. Если вы не в курсе: токен это примерно одно слово.
Внутреннее устройство одного (из тридцати) блока основного цикла обработки.
Как работает внимание. Откуда берётся "причинность": каждый токен видит только предыдущие, но не последующие.
Важная оптимизация: группируем запросы по три штуки, чтобы уменьшить размеры кэша внимания.
Как помогает кэш: не нужно перевычислять блоки, которые не меняются от шага к шагу.
Устройство KV-кэша.
Две фазы выполнения LLM-ки: предварительное заполнение (однократно) и декодирование (в цикле).
Как устроено LLM-приложение.
Как из вычисленных лоджитов образуется результирующий токен.
Куча мала в оперативной памяти.

no subject
Date: 2026-11-11 00:03 (UTC)no subject
Date: 2026-11-11 00:16 (UTC)https://en.wikipedia.org/wiki/Attention_(machine_learning)
Вот разъяснение от того же Клода: https://vak.dreamwidth.org/1606631.html